Die Seite aufbauen: So funktionieren Browser
Nutzer möchten Webangebote mit schnell ladenden Inhalten und reibungslosen Interaktionen. Entwickler sollten daher darauf hinarbeiten, diese Ziele zu erreichen.
Wenn Sie Änderungen umsetzen, die die tatsächliche und die wahrgenommene Performance verbessern, ist es hilfreich zu verstehen, wie der Browser funktioniert. Dieser Artikel erklärt, wie der Browser Inhalte lädt und welche Faktoren die Performance beeinflussen.
Überblick
Schnelle Websites bieten eine bessere Nutzererfahrung. Nutzer wünschen und erwarten schnell ladende Inhalte und eine reibungslose, reaktionsschnelle Bedienung.
Zwei zentrale Herausforderungen für die Web-Performance sind die Latenz und die Tatsache, dass Browser größtenteils nur einen Thread verwenden.
Die Latenz ist die größte Hürde für schnell ladende Seiten. Ziel von Entwicklern ist es, eine Website so schnell wie möglich laden zu lassen – oder sie zumindest scheinbar sehr schnell laden zu lassen –, damit Nutzer die angeforderten Informationen möglichst rasch erhalten. Netzwerklatenz ist die Zeit, die benötigt wird, um Bytes über das Netzwerk an Computer zu übertragen. Bei der Web-Performance geht es darum, die Seite möglichst schnell zu laden.
Browser gelten größtenteils als single-threaded. Das heißt, sie führen eine Aufgabe von Anfang bis Ende aus, bevor sie eine andere beginnen. Entwickler müssen für leistungsfähige Interaktionen mit der Website sorgen – vom flüssigen Scrollen bis zu reaktionsschnellen Touch-Interaktionen. Die Rendering-Zeit ist dabei entscheidend: Der Hauptthread muss alle ihm zugewiesenen Aufgaben erledigen und trotzdem für Nutzerinteraktionen verfügbar bleiben. Die Web-Performance lässt sich verbessern, indem Sie die Single-Thread-Eigenschaft des Browsers berücksichtigen und die Aufgaben des Hauptthreads minimieren. So ermöglichen Sie ein flüssiges Rendering und unmittelbare Reaktionen.
Navigation
Die Navigation ist der erste Schritt beim Laden einer Webseite. Sie beginnt, wenn ein Nutzer eine Seite anfordert, etwa durch Eingabe einer URL in die Adressleiste, Anklicken eines Links oder Absenden eines Formulars.
Ein Ziel der Web-Performance ist es, die Dauer bis zum Abschluss der Navigation zu minimieren. Latenz und Bandbreite können dabei Verzögerungen verursachen.
DNS-Abfrage
Der erste Schritt beim Aufrufen einer Webseite besteht darin, ihre Ressourcen zu finden. Wenn Sie https://example.com aufrufen, liegt die HTML-Seite auf einem Server mit der IP-Adresse 93.184.216.34. Beim ersten Besuch dieser Website erfolgt eine DNS-Abfrage.
Ihr Browser fordert eine DNS-Abfrage an, die schließlich von einem Nameserver beantwortet wird. Dieser liefert eine IP-Adresse zurück. Nach dieser ersten Anfrage wird die IP-Adresse wahrscheinlich zwischengespeichert. Das beschleunigt spätere Anfragen, weil die IP-Adresse aus dem Cache statt vom Nameserver abgerufen werden kann.
DNS-Abfragen sind beim Laden einer Seite normalerweise nur einmal pro Hostname erforderlich. Allerdings muss für jeden eindeutigen Hostnamen, auf den die angeforderte Seite verweist, eine DNS-Abfrage erfolgen. Wenn Ihre Schriftarten, Bilder, Skripte, Anzeigen und Messdienste jeweils unterschiedliche Hostnamen haben, ist für jeden davon eine DNS-Abfrage nötig.
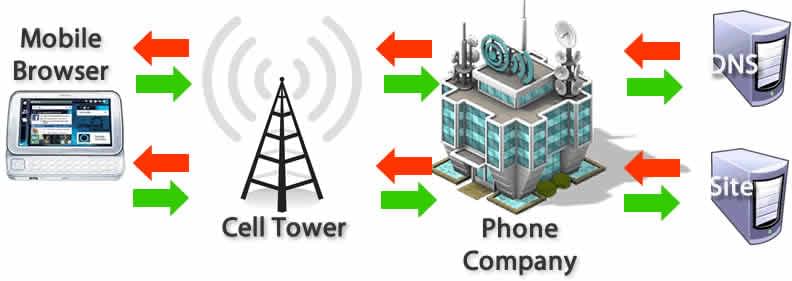
Das kann insbesondere in Mobilfunknetzen die Performance beeinträchtigen. Wenn ein Nutzer ein Mobilfunknetz verwendet, läuft jede DNS-Abfrage vom Telefon über den Mobilfunkmast zu einem autoritativen DNS-Server. Die Entfernung zwischen Telefon, Mobilfunkmast und Nameserver kann die Latenz erheblich erhöhen.
TCP-Handshake
Sobald die IP-Adresse bekannt ist, stellt der Browser über einen TCP-Three-Way-Handshake eine Verbindung zum Server her. Dieser Mechanismus ermöglicht es zwei Kommunikationspartnern – hier dem Browser und dem Webserver –, die Parameter der TCP-Socket-Verbindung auszuhandeln, bevor Daten übertragen werden, häufig über HTTPS.
Der TCP-Three-Way-Handshake wird oft als „SYN-SYN-ACK“ bezeichnet – genauer ist jedoch SYN, SYN-ACK, ACK –, weil TCP drei Nachrichten überträgt, um eine TCP-Sitzung zwischen zwei Computern auszuhandeln und zu starten, noch bevor die eigentliche Anfrage gestellt wird.
TLS-Aushandlung
Für sichere Verbindungen über HTTPS ist ein weiterer „Handshake“ erforderlich. Bei diesem Handshake, genauer gesagt bei der TLS-Aushandlung, wird festgelegt, welches Verschlüsselungsverfahren für die Kommunikation verwendet wird. Außerdem wird der Server überprüft und eine sichere Verbindung hergestellt, bevor die Datenübertragung beginnt. Dafür sind fünf weitere Hin- und Rückwege zum Server nötig, bevor die Inhaltsanfrage gesendet werden kann.
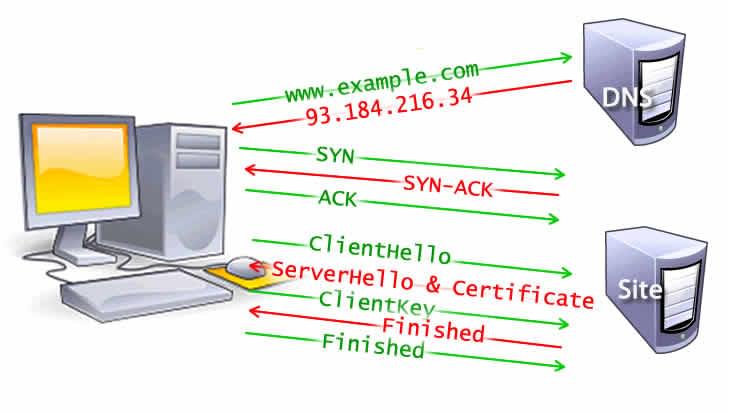
Die Absicherung der Verbindung verlängert zwar die Ladezeit der Seite, doch die zusätzliche Latenz lohnt sich: Dritte können die zwischen Browser und Webserver übertragenen Daten nicht entschlüsseln.
Nach acht Hin- und Rückwegen zum Server kann der Browser schließlich die Anfrage stellen.
Antwort
Sobald eine Verbindung zum Webserver besteht, sendet der Browser im Namen des Nutzers eine erste HTTP-GET-Anfrage. Bei Websites wird damit meistens eine HTML-Datei angefordert. Nachdem der Server die Anfrage erhalten hat, antwortet er mit den entsprechenden Antwort-Headern und dem HTML-Inhalt.
<!doctype html>
<html lang="en-US">
  <head>
    <meta charset="UTF-8" />
    <title>My simple page</title>
    <link rel="stylesheet" href="styles.css" />
    <script src="myscript.js"></script>
  </head>
  <body>
    <h1 class="heading">My Page</h1>
    <p>A paragraph with a <a href="https://example.com/about">link</a></p>
    <div>
      <img src="my-image.jpg" alt="image description" />
    </div>
    <script src="another-script.js"></script>
  </body>
</html>
Die Antwort auf diese erste Anfrage enthält das erste empfangene Datenbyte. Time to First Byte (TTFB) bezeichnet die Zeit zwischen der Anfrage des Nutzers – etwa einem Klick auf einen Link – und dem Empfang dieses ersten HTML-Pakets. Der erste Datenblock umfasst normalerweise 14 KB.
In unserem obigen Beispiel ist die Anfrage deutlich kleiner als 14 KB. Die verlinkten Ressourcen werden jedoch erst angefordert, wenn der Browser beim Parsen auf die Links stößt, wie weiter unten beschrieben.
Überlastkontrolle / TCP Slow Start
TCP teilt Daten für die Übertragung in Segmente auf und gewährleistet die zuverlässige Zustellung aller Segmente zwischen Server und Client. Der Client bestätigt empfangene Segmente mit ACK-Paketen. Der Server entscheidet, wie viele Segmente er sendet, bevor er auf eine Bestätigung wartet.
Diese Anzahl muss ausgewogen sein: Wartet der Server nach jedem Segment auf eine Bestätigung, verläuft die Übertragung langsam, weil er für jedes gesendete Segment einen vollständigen Hin- und Rückweg abwarten muss – selbst in einem wenig ausgelasteten Netzwerk. Sendet er dagegen zu viele Segmente gleichzeitig in ein stark ausgelastetes Netzwerk, können einige davon unterwegs verloren gehen. Der Client kann Segmente, die er nie erhalten hat, nicht bestätigen. Deshalb sendet der Server sie schließlich erneut.
TCP verwendet zwei getrennte Grenzen für die Menge nicht bestätigter Daten, die der Server gleichzeitig übertragen kann:
- Das Empfangsfenster (RWND) schützt den Client: Es teilt dem Server mit, wie viele eingehende Daten der Client momentan aufnehmen kann. Diese Grenze hängt vom verfügbaren Platz im Empfangspuffer des Clients ab. Der Client gibt sie dem Server bekannt, um die TCP-Flusskontrolle zu ermöglichen.
- Das Überlastfenster (CWND) schützt das Netzwerk: Es ist die Schätzung des Servers, wie viele Daten über die Verbindung zum Client übertragen werden können, ohne dass Segmente verloren gehen.
Der Server hat nie mehr unbestätigte Daten gleichzeitig in Übertragung, als das kleinere dieser beiden Fenster zulässt.
Das Überlastfenster ist anfangs klein und wird während der Übertragung angepasst. Während des TCP Slow Start wächst es schnell und verdoppelt sich ungefähr bei jedem Hin- und Rückweg, bis Segmente verloren gehen oder der TCP-Slow-Start-Schwellenwert (ssthresh) erreicht ist. Danach wächst es langsamer und wird verkleinert, sobald das Netzwerk Anzeichen einer Überlastung zeigt. Weitere Informationen zur TCP-Überlastkontrolle finden Sie in RFC 5681.
Parsen
Sobald der Browser den ersten Datenblock empfängt, kann er mit dem Parsen der erhaltenen Informationen beginnen. Beim Parsen wandelt der Browser die über das Netzwerk empfangenen Daten in das DOM und das CSSOM um. Diese verwendet der Renderer, um die Seite auf dem Bildschirm darzustellen.
Das DOM ist die interne Darstellung des Markups im Browser. Es ist auch zugänglich und lässt sich über verschiedene JavaScript-APIs verändern.
Selbst wenn das HTML der angeforderten Seite größer als das erste 14-KB-Paket ist, beginnt der Browser mit dem Parsen und versucht, anhand der bereits verfügbaren Daten Inhalte darzustellen. Für die Optimierung der Web-Performance ist es daher wichtig, alles, was der Browser für den Beginn des Renderings benötigt – oder zumindest das HTML- und CSS-Grundgerüst der Seite –, in den ersten 14 KB unterzubringen. Bevor etwas auf dem Bildschirm dargestellt werden kann, müssen jedoch HTML, CSS und JavaScript geparst werden.
Den DOM-Baum aufbauen
Wir beschreiben fünf Schritte des kritischen Rendering-Pfads.
Der erste Schritt besteht darin, das HTML-Markup zu verarbeiten und den DOM-Baum aufzubauen. Zum Parsen von HTML gehören die Tokenisierung und der Aufbau des Baums. HTML-Tokens umfassen Start- und End-Tags sowie Attributnamen und -werte. Wenn das Dokument wohlgeformt ist, lässt es sich einfach und schneller parsen. Der Parser verarbeitet die tokenisierte Eingabe und baut daraus den Dokumentbaum auf.
Der DOM-Baum beschreibt den Inhalt des Dokuments. Das Element <html> ist das erste Element und der Wurzelknoten des Dokumentbaums. Der Baum bildet die Beziehungen und Hierarchien zwischen den verschiedenen Elementen ab. Elemente, die in anderen Elementen verschachtelt sind, bilden Kindknoten. Je mehr DOM-Knoten vorhanden sind, desto länger dauert der Aufbau des DOM-Baums.
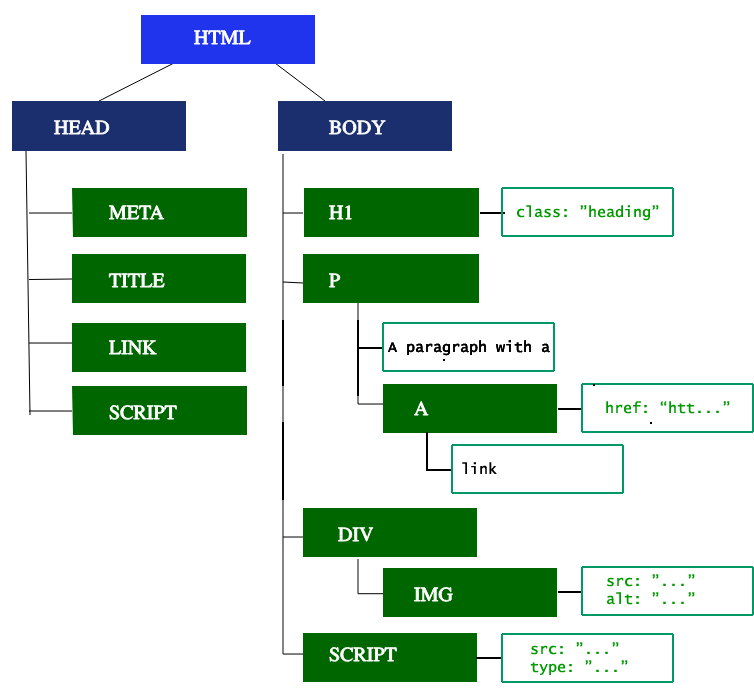
Wenn der Parser auf nicht blockierende Ressourcen wie ein Bild stößt, fordert der Browser diese an und setzt das Parsen fort. Auch bei einer CSS-Datei kann das Parsen weitergehen. <script>-Elemente hingegen – insbesondere solche ohne Attribut async oder defer – blockieren das Rendering und unterbrechen das Parsen von HTML. Zwar verringert der Preload-Scanner des Browsers die Auswirkungen solcher Blockierungen auf das Rendering, große Skripte können aber weiterhin einen erheblichen Engpass verursachen.
Preload-Scanner
Der Aufbau des DOM-Baums beansprucht den Hauptthread. Der Preload-Scanner analysiert die verfügbaren Inhalte und fordert Ressourcen mit hoher Priorität an, etwa CSS, JavaScript und Web-Schriftarten. Dank des Preload-Scanners müssen wir nicht warten, bis der Parser einen Verweis auf eine externe Ressource findet, um sie anzufordern. Der Scanner lädt Ressourcen im Hintergrund. Wenn der Haupt-HTML-Parser die entsprechenden Ressourcen erreicht, werden sie möglicherweise bereits übertragen oder sind schon heruntergeladen. Das reduziert Blockierungen.
<link rel="stylesheet" href="styles.css" />
<script src="my-script.js" async></script>
<img src="my-image.jpg" alt="image description" />
<script src="another-script.js" async></script>
In diesem Beispiel findet der Preload-Scanner die Skripte und das Bild und beginnt, sie herunterzuladen, während der Hauptthread HTML und CSS parst. Das Attribut async stellt sicher, dass das Skript den Ablauf nicht blockiert. Wenn die Reihenfolge beim Parsen und Ausführen von JavaScript wichtig ist, kann stattdessen das Attribut defer verwendet werden.
Das Warten auf CSS blockiert weder das Parsen von HTML noch das Herunterladen, wohl aber JavaScript: Skripte werden häufig verwendet, um die Auswirkungen von CSS-Eigenschaften auf Elemente abzufragen.
Den CSSOM-Baum aufbauen
Der zweite Schritt des kritischen Rendering-Pfads besteht darin, CSS zu verarbeiten und den CSSOM-Baum aufzubauen. Das CSS Object Model ähnelt dem DOM. DOM und CSSOM sind beides Bäume, aber voneinander unabhängige Datenstrukturen. Der Browser wandelt CSS-Regeln in eine Zuordnung von Stilen um. Dazu gehört ein Baum aus Knoten mit Eltern-, Kind- und Geschwisterbeziehungen, die auf den CSS-Selektoren beruhen.
Wie bei HTML wandelt der Browser die empfangenen CSS-Regeln in eine Form um, mit der er arbeiten kann. Er wiederholt also den Vorgang, bei dem HTML in Objekte umgewandelt wird – diesmal für CSS.
Der CSSOM-Baum enthält auch Stile aus dem Stylesheet des User Agents. Der Browser beginnt mit der allgemeinsten Regel, die für einen Knoten gilt, und verfeinert die berechneten Stile rekursiv durch die Anwendung spezifischerer Regeln. Mit anderen Worten: Die Eigenschaftswerte durchlaufen die Kaskade.
Der Aufbau des CSSOM ist schnell und wird in den Entwicklertools nicht direkt angezeigt. Stattdessen zeigt die Kennzahl „Recalculate Style“ in den Entwicklertools die Gesamtzeit für das Parsen von CSS, den Aufbau des CSSOM-Baums und die rekursive Berechnung der Stile. Für die Performance-Optimierung können Sie Ihre Zeit sinnvoller einsetzen: Der Aufbau des CSSOM dauert im Allgemeinen kürzer als eine einzige DNS-Abfrage.
Weitere Prozesse
JavaScript-Kompilierung
Während CSS geparst und das CSSOM erstellt wird, werden weitere Ressourcen heruntergeladen, darunter JavaScript-Dateien – dank des Preload-Scanners. JavaScript wird geparst, kompiliert und interpretiert. Die Skripte werden in abstrakte Syntaxbäume umgewandelt. Einige Browser-Engines übergeben die abstrakten Syntaxbäume an einen Compiler, der Bytecode erzeugt. Dies wird als JavaScript-Kompilierung bezeichnet. Der Großteil des Codes wird auf dem Hauptthread interpretiert. Ausnahmen sind beispielsweise Codeausführungen in Web Workern.
Den Accessibility-Baum aufbauen
Der Browser erstellt außerdem einen Accessibility-Baum, den assistive Technologien zum Analysieren und Interpretieren von Inhalten verwenden. Das Accessibility Object Model (AOM) ist gewissermaßen eine semantische Version des DOM. Der Browser aktualisiert den Accessibility-Baum und das DOM gleichzeitig. Assistive Technologien können den Accessibility-Baum nicht direkt verändern.
Solange das AOM nicht aufgebaut ist, sind die Inhalte für Screenreader nicht zugänglich.
Rendering
Zu den Rendering-Schritten gehören die Berechnung der Stile, das Layout, das Zeichnen und in manchen Fällen das Compositing. Die beim Parsen erstellten CSSOM- und DOM-Bäume werden zu einem Render-Baum zusammengeführt. Anhand dieses Baums wird das Layout jedes sichtbaren Elements berechnet, das auf dem Bildschirm dargestellt wird. In manchen Fällen können Inhalte eine eigene Ebene erhalten und per Compositing zusammengesetzt werden. Das kann die Performance verbessern, weil Teile des Bildschirms auf der GPU statt auf der CPU gezeichnet werden und der Hauptthread dadurch entlastet wird.
Stile
Der dritte Schritt des kritischen Rendering-Pfads besteht darin, DOM und CSSOM zu einem Render-Baum zusammenzuführen. Der Aufbau dieses Baums mit berechneten Stilen beginnt an der Wurzel des DOM-Baums und durchläuft jeden sichtbaren Knoten.
Elemente, die nicht angezeigt werden – etwa das Element <head> und seine Kindknoten sowie Knoten mit display: none, wie bei script { display: none; } in User-Agent-Stylesheets –, werden nicht in den Render-Baum aufgenommen. Sie erscheinen nicht in der gerenderten Ausgabe. Knoten mit visibility: hidden gehören dagegen zum Render-Baum, weil sie Platz beanspruchen. Da wir keine Anweisungen zum Überschreiben der Standardeinstellungen des User Agents angegeben haben, wird der script-Knoten aus unserem obigen Codebeispiel nicht in den Render-Baum aufgenommen.
Auf jeden sichtbaren Knoten werden seine CSSOM-Regeln angewendet. Der Render-Baum enthält alle sichtbaren Knoten samt Inhalt und berechneten Stilen: Er ordnet jedem sichtbaren Knoten im DOM-Baum die relevanten Stile zu und bestimmt anhand der CSS-Kaskade die berechneten Stile für jeden Knoten.
Layout
Der vierte Schritt des kritischen Rendering-Pfads besteht darin, anhand des Render-Baums das Layout und damit die Geometrie jedes Knotens zu berechnen. Beim Layout werden die Abmessungen und Positionen aller Knoten im Render-Baum sowie die Größe und Position jedes Objekts auf der Seite bestimmt. Als Reflow bezeichnet man jede spätere Neuberechnung von Größe und Position für einen Teil der Seite oder das gesamte Dokument.
Sobald der Render-Baum aufgebaut ist, beginnt die Layout-Berechnung. Der Render-Baum gibt an, welche Knoten dargestellt werden – auch wenn sie unsichtbar sind – und welche berechneten Stile sie haben. Er enthält jedoch noch nicht ihre Abmessungen oder Positionen. Um die genaue Größe und Position jedes Objekts zu bestimmen, durchläuft der Browser den Render-Baum von der Wurzel aus.
Auf einer Webseite ist fast alles eine Box. Unterschiedliche Geräte und Desktop-Einstellungen führen zu einer praktisch unbegrenzten Zahl verschiedener Viewport-Größen. In dieser Phase bestimmt der Browser unter Berücksichtigung der Viewport-Größe die Abmessungen aller Boxen auf dem Bildschirm. Die Layout-Berechnung beginnt normalerweise beim Body. Dabei legt der Browser die Größen aller Nachkommen des Body fest und reserviert Platzhalter für ersetzte Elemente mit unbekannten Abmessungen, etwa für unser Bild.
Die erstmalige Bestimmung von Größe und Position jedes Knotens heißt Layout. Spätere Neuberechnungen des Layouts heißen Reflows. Angenommen, in unserem Beispiel findet das erste Layout statt, bevor das Bild eingetroffen ist. Da wir keine Bildabmessungen angegeben haben, erfolgt ein Reflow, sobald sie bekannt sind.
Zeichnen
Der letzte Schritt des kritischen Rendering-Pfads besteht darin, die einzelnen Knoten auf dem Bildschirm darzustellen. Das erste Mal wird als First Meaningful Paint bezeichnet. In der Zeichen- beziehungsweise Rasterisierungsphase wandelt der Browser jede in der Layout-Phase berechnete Box in tatsächliche Bildschirmpixel um. Dabei zeichnet er jeden sichtbaren Teil eines Elements, einschließlich Text, Farben, Rahmen, Schatten und ersetzten Elementen wie Schaltflächen und Bildern. Das muss sehr schnell geschehen.
Für flüssiges Scrollen und flüssige Animationen muss der Browser alle Vorgänge auf dem Hauptthread – einschließlich Stilberechnung, Reflow und Zeichnen – in weniger als 16,67 ms erledigen. Bei einer Auflösung von 2048 × 1536 müssen auf einem iPad mehr als 3.145.000 Pixel auf dem Bildschirm dargestellt werden. Sehr viele Pixel müssen also sehr schnell gezeichnet werden. Damit spätere Neuzeichnungen schneller ablaufen als das erste Zeichnen, wird die Bildschirmausgabe gewöhnlich auf mehrere Ebenen verteilt. Das erfordert Compositing.
Beim Zeichnen können die Elemente des Layout-Baums auf Ebenen verteilt werden. Werden Inhalte auf eigene Ebenen auf der GPU verschoben – statt auf dem Hauptthread der CPU gezeichnet zu werden –, verbessert das die Performance beim Zeichnen und Neuzeichnen. Bestimmte Eigenschaften und Elemente erzeugen eine Ebene, darunter <video> und <canvas> sowie Elemente mit den CSS-Eigenschaften opacity, einem 3D-transform, will-change und einigen weiteren. Diese Knoten und ihre Nachkommen werden auf einer eigenen Ebene gezeichnet, sofern ein Nachkomme nicht aus einem oder mehreren der genannten Gründe selbst eine eigene Ebene erhält.
Ebenen verbessern die Performance, verursachen aber Kosten bei der Speicherverwaltung. Im Rahmen der Web-Performance-Optimierung sollten sie daher nicht übermäßig eingesetzt werden.
Compositing
Wenn Teile des Dokuments auf verschiedenen, sich überlappenden Ebenen gezeichnet werden, ist Compositing nötig. So wird sichergestellt, dass die Ebenen in der richtigen Reihenfolge auf dem Bildschirm erscheinen und die Inhalte korrekt dargestellt werden.
Während die Seite weitere Ressourcen lädt, kann es zu Reflows kommen – denken Sie an unser Beispielbild, das erst später eintrifft. Ein Reflow löst eine Neuzeichnung und ein erneutes Compositing aus. Hätten wir die Abmessungen des Bildes angegeben, wäre kein Reflow nötig gewesen. Nur die betroffene Ebene hätte bei Bedarf neu gezeichnet und zusammengesetzt werden müssen. Wir haben die Bildabmessungen jedoch nicht angegeben! Sobald das Bild vom Server eintrifft, kehrt der Rendering-Prozess deshalb zur Layout-Phase zurück und beginnt von dort an erneut.
Interaktivität
Nachdem der Hauptthread die Seite gezeichnet hat, könnte man meinen, der Vorgang sei abgeschlossen. Das ist nicht unbedingt der Fall. Wenn beim Laden JavaScript eingebunden wurde, dessen Ausführung korrekt auf einen Zeitpunkt nach dem Auslösen des onload-Ereignisses verschoben wurde, ist der Hauptthread möglicherweise beschäftigt und steht für Scrollen, Touch-Bedienung und andere Interaktionen nicht zur Verfügung.
Time to Interactive (TTI) misst die Zeit von der ersten Anfrage, die zur DNS-Abfrage und TCP-Verbindung führte, bis zu dem Zeitpunkt, an dem die Seite interaktiv ist. Dieser Zeitpunkt liegt nach dem First Contentful Paint und ist erreicht, wenn die Seite innerhalb von 50 ms auf Nutzerinteraktionen reagiert. Wenn der Hauptthread JavaScript parst, kompiliert und ausführt, steht er nicht zur Verfügung und kann nicht rechtzeitig – also innerhalb von weniger als 50 ms – auf Nutzerinteraktionen reagieren.
Nehmen wir an, in unserem Beispiel wurde das Bild schnell geladen, aber die Datei another-script.js war 2 MB groß und die Netzwerkverbindung des Nutzers langsam. In diesem Fall würde der Nutzer die Seite schnell sehen, könnte aber erst nach dem Herunterladen, Parsen und Ausführen des Skripts ohne Ruckeln scrollen. Das ist keine gute Nutzererfahrung. Vermeiden Sie es, den Hauptthread zu blockieren, wie dieses WebPageTest-Beispiel zeigt:
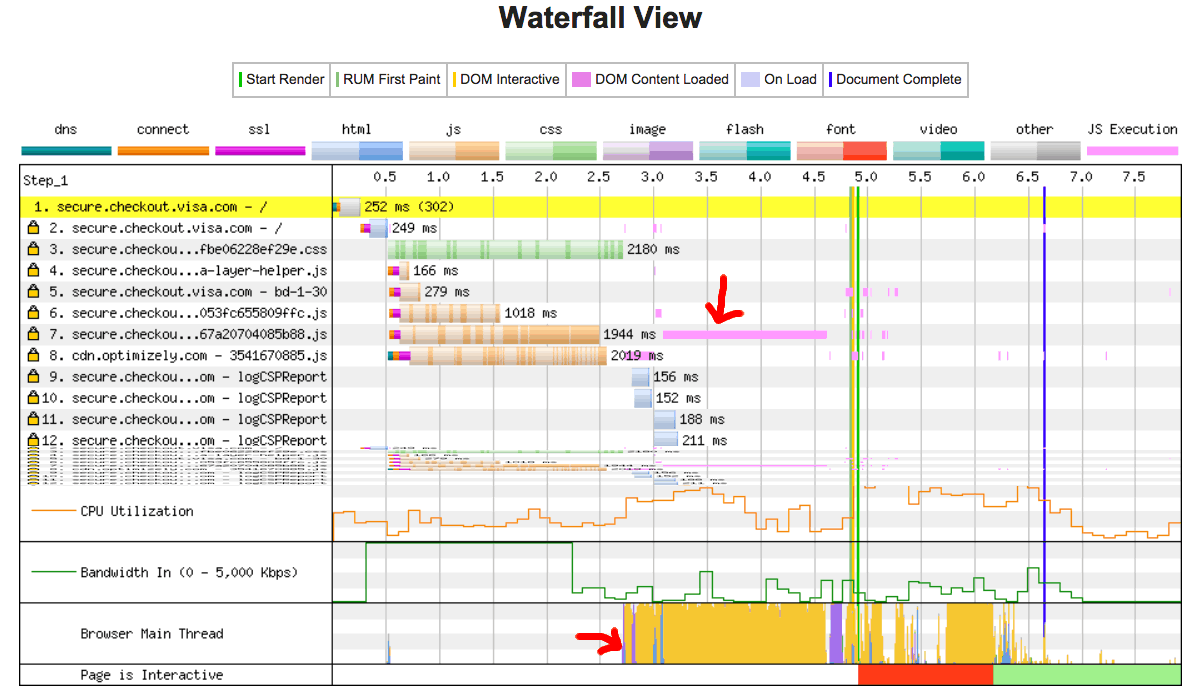
In diesem Beispiel dauerte die Ausführung von JavaScript mehr als 1,5 Sekunden. Während dieser gesamten Zeit war der Hauptthread vollständig belegt und reagierte weder auf Klicks noch auf Berührungen des Bildschirms.